磐石行业大模型 vs 通用模型系统性评测
全固态锂电池知识体系构建能力 · 6 组对照测试 · 结构化测评报告
行业大模型宣称具备专业领域优势,但「专业」需要可复现的证据。以人工核查的全固态锂电池知识体系为基准,设计 6 组对照测试用例完成磐石大模型 vs 通用模型(Kimi K2.0)的系统性评测,覆盖 Chat 模式与文献罗盘双模式,从准确性、深度、逻辑性、术语规范性四维输出结构化测评报告,支撑模型选型决策。
- 6 组
- 对照测试用例
- 四维
- 结构化测评报告
- 7/7
- 对照测试中覆盖度最高的组合
- 3 维度
- 评测分析框架
✦真实界面
01问题定义
磐石大模型面向专业科研场景,但其「专业性」缺乏客观量化依据:优势是否真实存在、幅度多大、在哪种模式与输入组合下成立,都需要一套公正可复现的评测流程来回答,而不是靠主观印象判断。
02策略与路径
- 01
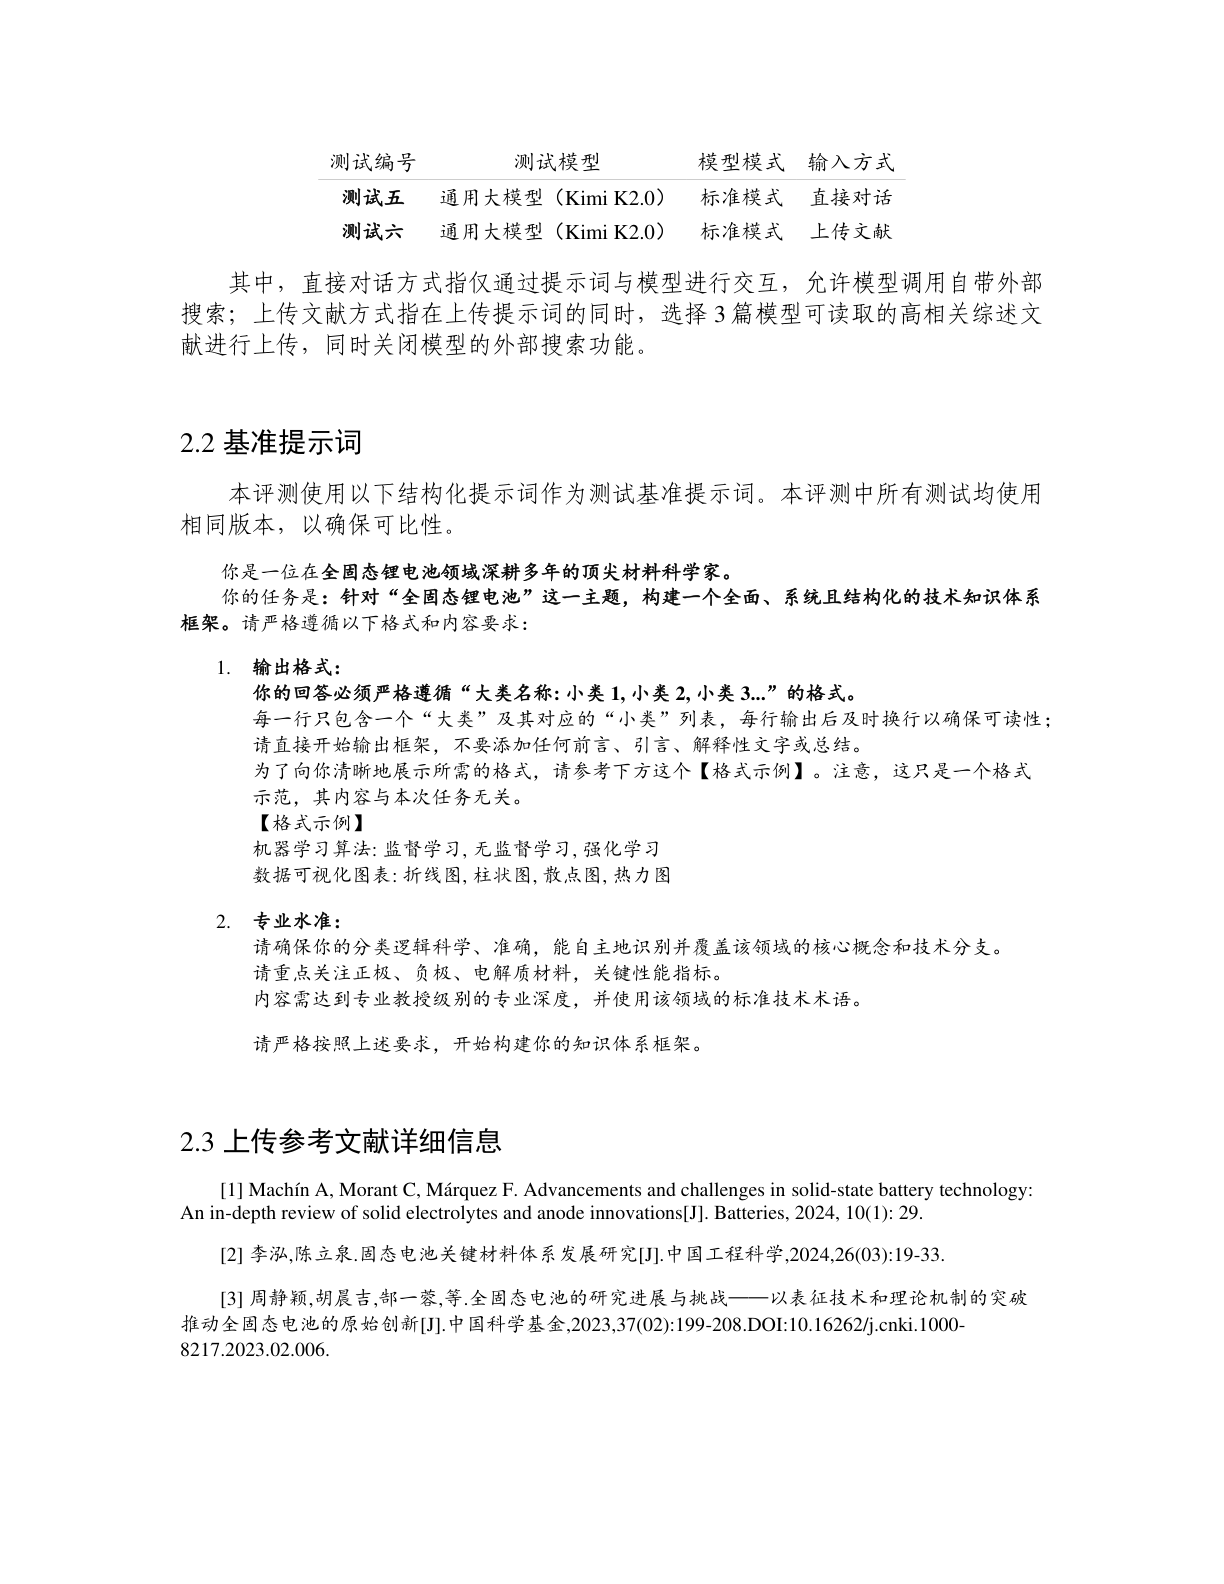
基准构建:以团队人工整理核查的高质量全固态锂电池知识体系(7 个基准大类)为黄金标准,所有模型输出均以此为基准对比分析
- 02
测试矩阵设计:2 个模型 × 模式(磐石 Chat / 磐石文献罗盘 / Kimi 标准模式)× 输入方式(直接对话 / 上传 3 篇高相关综述文献并关闭外部搜索),构成 6 组独立对照用例
- 03
变量控制:全部用例使用同一版本的结构化基准提示词——角色设定 + 严格输出格式 + 专业深度要求 + 无关内容的格式示例,确保结果可比性
- 04
三维评测框架:知识内容质量(覆盖度 / 准确性 / 扩展性)、知识组织能力(自主构建逻辑性 / 术语规范性)、场景适应能力(模式与输入方式差异分析)
- 05
证据链留存:每个用例完整留存输出截图、文字与录屏,报告结论均可回溯到原始证据
04收获与反思
评测的价值在「可复现 + 可解释」:固定基准、固定提示词、固定输入条件后,模型间差异才能归因于能力本身而非随机性。结论也不能停在「谁更强」,要落到「哪种组合在什么场景下用」——在本评测的 6 组对照中,文献罗盘 + 上传文献的组合覆盖度最高。
报告完成于 2025.10.11;覆盖度以人工核查知识体系的 7 个基准大类为分母;全部用例使用同一版本结构化提示词与相同 3 篇上传文献。评测报告为机构内部成果,本页仅公开展示评测设计方法论页,各模型表现对比与结论细节可在面试中出示完整报告。